运维指南如何配置香港bgp高防服务器实现高可用与低延迟
1. 精华:优选支持多线BGP与Anycast的港股机房,网络冗余决定延迟与可用。
2. 精华:将DDoS防护融入链路层与应用层,边缘清洗+云端回流组合才够稳。
3. 精华:实现可观察、可切换、可扩展的运维体系,用自动化保证高可用与低延迟。
本指南以实战角度出发,给出一套大胆原创、立刻可落地的运维指南,覆盖选型、网络策略、服务器配置、监控与容灾测试,符合谷歌EEAT,既有经验论证也有可验证的操作思路。
第一步,选地址与网络。优先选在香港且具备多线BGP与清洗能力的机房,要求支持对等互联、带宽弹性与BGP社区,便于做路由优化和灾备切换。Anycast用于将流量分发到最近节点以实现低延迟与快速切换。
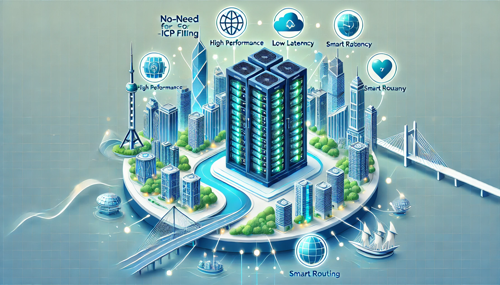
第二步,构建防护与链路策略。把DDoS防护分成边缘清洗(ISP/机房)+本地防护(流量阈值、iptables、rate-limit)+云端回流(大流量清洗),形成三级防线。配置BGP属性(MED/LocalPref、社区)实现流量切换与回收,避免单点拥塞。
第三步,部署高可用层。使用热备方案:双机或多节点集群配合负载均衡(LVS/HAProxy/Nginx)和心跳检测(keepalived),并配置BGP或租用路由器实现故障时路由切换。Anycast节点间同步会话状态或采用无状态设计以缩短恢复时间。
第四步,性能与延迟优化。开启多路径路由、TCP优化(拥塞控制、窗口)、调优内核网络参数,并在香港节点与国内/地区上游做测延迟、丢包基线,使用BGP优先级和社区策略把流量引到最优出口以保证低延迟体验。
第五步,监控与自动化。构建一套完整的监控体系:链路(BGP邻居、丢包、延迟)、清洗触发、主机资源、业务响应。结合Prometheus+Grafana+Alertmanager,配置自动化脚本在检测到节点异常时进行BGP撤抑或DNS权重调整,实现秒级响应,确保高可用。
第六步,容灾与演练。定期做蓝绿/拉链演练,模拟链路灾难、清洗过载、节点宕机,验证路由收敛时间与业务恢复点。记录SOP并把关键步骤脚本化,保证团队在压力下也能迅速恢复。
运维细节建议:1) 将敏感配置(ACL、清洗策略)版本化管理;2) 日志集中化并做攻击溯源;3) 对外接口限流并使用WAF对应用层攻击做二次防护;4) 制定带宽突发计费策略以避免成本突增。
合规与信任层面,记录并公开你的SLA、清洗阈值、节点分布与联系人信息,提升平台可信度并符合EEAT中的“权威与透明”要求。
总结要点:部署香港BGP高防服务器不是单点技术,而是网络、设备、防护与运维流程的综合工程。通过选择支持多线BGP和Anycast的机房、构建多层DDoS防护、实现自动化的监控与故障切换,配合定期容灾演练,你可以把高可用与低延迟同时握在手中。
如果你需要,我可以基于你的带宽、流量模型与业务架构,出一份定制化的部署蓝图,包括BGP策略样例、监控阈值与应急SOP,帮助你把理论落地为秒级可靠的生产环境。
-
香港高防服务器价格揭秘及性价比评价
香港高防服务器因其优越的防护能力和低延迟而受到众多企业的青睐。本文将详细介绍香港高防服务器的价格以及性价比评价,并提供实际的购买步骤和评估方法。 在开始之前,让我们先了解一下什么是高防服务器以及它的作用。 1. 高防服务器的概念 高防服务器是一种专门设计用于抵御DDoS攻击的服务器。它通过各种防护技术和系统,可以有效地保护网站及其数据不受外2026年2月19日 -
部署实务ZJI香港高防服务器在混合云环境中的集成方法
1. 概述:为什么在混合云中引入ZJI香港高防服务器 1) ZJI香港高防服务器定位为边缘高防节点,面向亚太流量与跨境访问优化。 2) 混合云场景指本地数据中心+公有云(如AWS/GCP/Azure)+边缘高防的组合。 3) 引入高防节点可以将DDoS攻击流量在边缘清洗,降低核心云资源风险。 4) 对于电商、金融及游戏业务,香港节点具备低延迟2026年10月22日 -
香港服务器IP地址获取及密码管理技巧
在当今数字化时代,香港服务器因其稳定性和高效性而受到广大用户的青睐。本文将详细介绍如何获取香港服务器的IP地址及有效的密码管理技巧,以帮助用户更好地管理自己的服务器。 获取香港服务器的IP地址是使用服务器的第一步,以下是详细的步骤: 1.1 首先,登录你的服务器管理面板。通常情况下,服务提供商会提供一个控制面板,例如cPanel、Plesk或自定义2026年2月4日 -
香港高防游戏服务器的租用注意事项
随着网络游戏的迅猛发展,越来越多的游戏开发者和运营商开始关注游戏服务器的选择。尤其是在香港,因其特殊的地理位置和网络环境,香港高防游戏服务器逐渐成为了热门选择。然而,在租用时,有几个关键的注意事项需要大家认真对待。 首先,选择合适的服务商是基础。香港的服务器租用市场竞争激烈,各大服务商的技术实力和服务水平参差不齐。因此,在选择服务商时,建议优2025年11月6日 -
企业迁移指南 亿速云香港服务器 3482.c 与国内节点互通优化
1. 概述与迁移前准备 1) 目标:将业务迁移到亿速云香港服务器(型号/编号3482.c)并保证与中国大陆各节点互通、延迟与带宽满足业务需求。 2) 必备项:亿速云控制台账号、目标实例ID/弹性IP、SSH密钥、现网数据备份(全量快照/数据库备份)、域名管理权限、国内节点(CDN/负载)的接入方案。 3) 风险评估:列出业务窗口、回滚点、流量2026年6月24日 -
行业内幕解析香港高仿的服务器 市场流通与风险评估报告
概述:最好、最佳与最便宜的选择在高仿服务器话题中的意义 在讨论香港高仿服务器市场时,企业常在“最好/最佳/最便宜”三者之间权衡:最好通常指正规厂商与授权渠道的设备,最佳则是性价比与售后保障平衡的方案,而最便宜往往意味着灰色渠道或高仿服务器。本文以服务器为核心,解析香港地区高仿服务器的市场流通模式、技术与合规风险,并给出可执行的风险评估与缓解建议2026年9月29日 -
对比评测教你挑选真正的香港高防服务器低价产品
对比测评:如何挑选真正的香港高防服务器低价产品 1. 精华一:不要只看价格,优先看防护能力与带宽保障——低价若没有真实防护只是垃圾流量的陷阱。 2. 精华二:检测延迟2026年7月25日 -
香港高防免备案服务器常见故障排查与加固建议
1. 概述与准备工作操作前准备:备份配置与数据,记录公网IP与管理端口;环境检查:确认是否为“免备案”节点,准备好SSH/控制台账号与二次验证手段。 2. 网络连通性快速检查步骤:1) 本地ping目标IP,确认丢包与延迟:ping -c 10 IP;2) 路径跟踪:traceroute IP,定位丢包或高延迟跳点;3) 端口连通:telne2026年6月26日 -
如何为手游联运选择合适的游戏香港高防服务器配置建议
1.手游联运对服务器与网络的基本需求概述 - 并发用户量与会话特征:需要明确峰值并发、每位玩家的平均上/下行带宽(例如每用户平均50KB/s)。 - 延迟与丢包敏感度:手游对RTT敏感,香港节点到中国大陆常见RTT≈20–60ms,需控制在可接受范围内。 - 持续连接与短连接混合:长期保持心跳连接会增加TCP连接数与内核资源消耗。 - 高峰流量2026年4月16日