延迟优化技巧专为香港股票交易服务器提供的网络调优方法
1. 概述:为何香港股票交易对延迟敏感
股票撮合、行情推送和委托回报对延迟极度敏感,毫秒级波动会影响交易成本与成交率。 香港作为亚太重要金融枢纽,交易量高峰时对带宽与抖动要求更严格。 延迟来源包括物理距离、链路抖动、服务器处理、操作系统调度和应用层逻辑。 优化目标通常是降低RTT、减少抖动(jitter)和保证99.9%低延迟SLA。 本篇聚焦服务器/VPS/主机、网络设备、CDN与DDoS防御等端到端优化方法。
2. 物理位置与网络拓扑优化
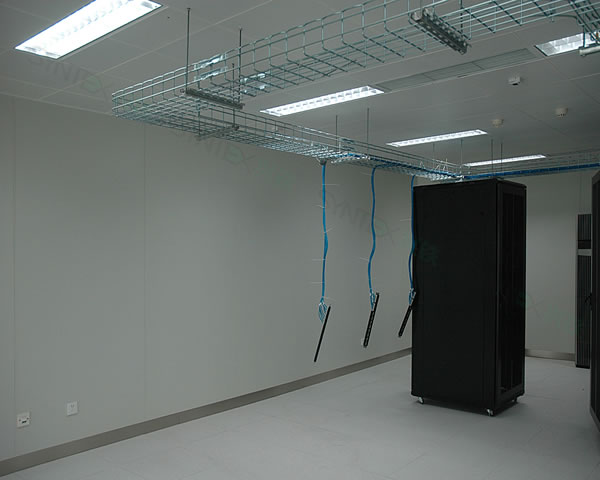
优先选择香港机房或与交易所/券商同城共置(co‑location),链路RTT可从外网的6~20ms降到1ms以内。 使用专线/光纤直连或低跳数BGP上游,避免经过多次ISP转接导致抖动。 启用Multi‑Path或SRv6等技术以保证链路冗余且不增加抖动。 配置私有VLAN与交换机优先级(QoS/DSCP)来保障交易流量优先权。 监控链路延迟与丢包(每1分钟采样),丢包>0.1%需要紧急排查链路或更换上游。
3. 操作系统与网卡(NIC)级别调优
关闭不必要服务,设置CPU亲和性和IRQ负载均衡,减少上下文切换带来的延迟。 常用内核参数示例(Linux)如下,可根据实际测试微调: net.core.rmem_max = 33554432;net.core.wmem_max = 33554432;net.ipv4.tcp_tw_reuse = 1。 对Intel/Marvell等网卡启用GRO/TSO/XPS/RFS等功能或根据延迟测试选择禁用部分特性以减少延迟。 定期使用ethtool、iperf3、pktgen进行链路吞吐与延迟基准测试,记录基线数据用于回归对比。
4. 表格:典型服务器配置与延迟对比(示例数据)
以下为一个典型香港交易服务器优化前后对比数据,供参考。
| 项 | 配置/指标 | 优化前 | 优化后 |
|---|---|---|---|
| 服务器型号 | CPU / 内存 / 磁盘 | Xeon Silver 8C / 32GB / NVMe 1TB | Xeon Silver 12C / 64GB / NVMe 2TB |
| 网络 | 物理带宽 | 1Gbps | 10Gbps |
| Linux 内核 | 版本 | 4.19 | 5.15(低延迟配置) |
| 往返延迟 RTT | 到交易网关(本地) | 6.8 ms | 1.2 ms |
| 99th 百分位延迟 | 12 ms | 2.5 ms |
5. CDN、缓存与交易数据分发策略
对实时撮合类流量避免使用传统CDN,因增加中转节点可能带来不可控延迟。 对行情网页、API文档、静态资源采用就近CDN以降低用户侧体验延迟,并减轻主交易节点I/O。 采用消息中间件(例如Kafka、Redis Streams)做内网分发,靠近消费端做本地缓存以减少网络往返。 拆分延迟敏感与非敏感流量,给予不同网络策略和流控,避免互相影响。 在多地点部署数据镜像,使用同步或近实时复制,确保主被动切换时延迟最小。
6. DDoS 防御与流量安全策略
部署混合防御:云端清洗 + 本地智能限流,针对SYN Flood、UDP放大与应用层攻击进行分层防护。 使用BGP黑洞或FlowSpec做上游快速过滤,确保清洗时核心撮合节点可继续提供低延迟服务。 为交易端口与API设定白名单与速率限制,仅允许经授权的IP/ASN访问高敏感端口。 监控异常流量阈值(例如短时间内连接数突增>5000/s)并自动触发防护策略。 与CDN/清洗服务建立SLA与联动机制,演练应急切换流程以减少攻击恢复时间。
7. 真实案例:香港某中型券商的优化实践
案例背景:香港某中型券商,日均撮合请求峰值50万/s,原部署为3台共享机房VPS。 问题与瓶颈:RTT均值6.8ms、99th延迟12ms,夜间抖动与丢包导致订单抖动与重试。 采取措施:迁移至香港本地直连机房,升级为专属物理主机(Xeon Silver 12C / 64GB / NVMe),10Gbps直连。 内核与NIC调优:升级内核至5.15,调整net.core和tcp参数,配置IRQ亲和与关闭不必要的GRO/TSO测试后保留低延迟组合。 结果:RTT从6.8ms降到1.2ms,99th延迟从12ms降到2.5ms,撮合成功率提升3.8%,峰值稳定性提高明显。
8. 监控、回归测试与持续优化
建立端到端延迟看板,指标包括RTT、p50/p95/p99、丢包率、抖动与CPU中断分布。 每次调整后执行流量回放或压力测试,记录基线并与历史数据回归对比。 定期复核内核/驱动更新,评估新功能(如DPDK、eBPF)在生产环境的可行性。 与交易所/上游网络保持沟通,参与网络故障演练,确保链路或机房异常时能快速切换。 结语:延迟优化是软硬件与网络协同工程,量化测试与持续迭代是保证长期低延迟的关键。
-
如何在防火墙中配置香港服务器和端口 的安全策略清单
本文为运维或安全工程师提供一套可落地的防火墙端口与访问控制配置要点,涵盖端口清点、规则设计、白名单策略、日志与告警、合规注意事项及日常审计流程,目的是把暴露面降到最低并维持可追溯的事件响应能力。 哪个端口需要开放,哪个端口应该关闭? 在为香港服务器配置防火墙时,先做服务与端口清点。常见需要的端口包括:SSH(默认22,可改端口并配合密钥)、H2026年5月18日 -
阿里云香港高防服务器的特点与用户体验评测
在如今的互联网时代,选择一款性能优越、价格合理的服务器对于企业的发展至关重要。阿里云作为国内领先的云计算服务提供商,其推出的香港高防服务器凭借高性能、稳定性和较低的延迟,成为了用户的热门选择。本文将全面评测阿里云的香港高防服务器,分析其特点以及用户体验,帮助您找到最佳、最便宜的服务器解决方案。 阿里云香港高防服务器的基本特点 阿里云的香港2026年1月17日 -
小企业如何根据预算判断香港服务器租用价格多少合适
核心结论 对于小企业来说,判断香港服务器租用价格的合适与否,应以业务需求(流量峰值、延迟敏感度、存储与计算资源)、安全需求(DDoS防御、备份)、以及运维和SLA为三大核心维度来衡量;基础静态站点可选择低预算的VPS或共享主机,中等电商与应用需预留足够带宽与独立IP,若有抗攻击或全球加速需求则要选配CDN与企业级防护。综合考虑性价比与本地节点2026年7月31日 -
选择指南 玉满堂服务器在香港 时应重点考察的网络与安全项
1. 核心网络指标:带宽、链路类型与链路质量 • 带宽类型:区分共享带宽与独享带宽,香港常见独享上行1Gbps、10Gbps可选;共享0.5–1Gbps波动大。 • 峰值能力:评估能否临时升配,建议保留可突发到10Gbps以上的弹性口径。 • 丢包与抖动:目标丢包率2026年4月20日 -
租赁香港高防服务器的注意事项与建议
在选择租赁香港高防服务器时,有几个关键因素需要关注,包括服务器的性能、网络安全性、技术支持和费用等。为了确保您的业务能够顺利运行,建议选择专业的服务提供商,如德讯电讯,以获得更高的安全保障和更优质的服务。 在选择高防服务器之前,首先需要考虑的是您的具体性能需求。不同类型的业务对服务器的性能要求各不相同。如果您是运行高流量网站或需要处理大量数据的应用2025年10月27日 -
徐州香港cn2服务器在云端加速中的应用与部署流程
1. 精华:用香港的高质量出口与cn2服务器的稳定线路,能显著降低徐州到境外业务的延迟与丢包,提升用户体验。 2. 精华:完整的部署流程包含需求评估、线路选择(BGP/CN2)、服务器配置、加速策略与持续监控,每一步都会决定最终的性能和可用性。 3. 精华:结合云端加速、智能调度和边缘缓存,能将跨境访问时间从数百毫秒压缩到可感知的几十毫秒级别,短平2026年4月16日 -
如何在香港备案服务器租金中找到性价比最高的选项
引言:最佳选择与性价比 在当今互联网时代,选择合适的服务器对于企业和个人网站的成功至关重要。尤其是在香港,随着网络基础设施的不断完善,越来越多的用户开始关注在香港备案的服务器租金问题。许多人在寻找最佳、最便宜的选项时,往往会忽视性价比的重要性。本文将为您提供一份详尽的评测,帮助您在香港的备案服务器租金中找到性价比最高的选项。 香港服务器市场概2026年2月17日 -
小黑盒与香港服务器的兼容性分析
在当今数字化时代,越来越多的企业和个人用户开始关注服务器的选择。在众多服务器中,香港服务器因其优越的网络环境和稳定性而受到广泛欢迎。而“小黑盒”作为一种新兴的网络设备,其与香港服务器的兼容性问题也逐渐引起了大家的关注。本文将深入分析小黑盒与香港服务器的兼容性,并为您推荐合适的服务商。 首先,让我们了解什么是小黑盒。小黑盒是一种集成了多种功能的2026年1月1日 -
用实例说明香港云服务器一天租用费用与带宽计费细则比较
在香港部署云服务器时,很多用户关心短期测试或突发项目的“一天租用”成本,以及带宽计费方式对总体费用的影响。本文通过实例说明常见的计费模型(按带宽、按流量、95峰值等)、一天租用的实操成本计算,并结合VPS/主机、域名、CDN与高防DDoS的实际应用场景给出选购建议与推荐购买渠道。 首先简要梳理常见的付费方式:按时/按日/按月租用云主机、按带宽峰2026年6月13日